

Подрядчики OpenAI читают реальные диалоги в ChatGPT
Вечер. В офисе уже погас свет, а ты сидишь перед монитором и собираешь запуск нового продукта. В окно чата летят свежие транскрипты глубинных интервью с клиентами, черновик коммерческого предложения с закрытыми скидками, сырые цифры маржинальности и наброски позиционирования. Ты просишь нейросеть убрать лишний канцелярит и переписать закрывающие возражения. Интерфейс выглядит уютно: белое поле, минималистичный дизайн, диалог один на один с умным алгоритмом. Возникает стойкое ощущение, что это твой личный приватный блокнот, закрытый на цифровой замок.
Знакомо? А теперь суровая реальность: никакого приватного сейфа там нет. Между твоим промптом и серверами нейросети крутится огромный конвейер ручной проверки. Сотни внешних подрядчиков каждый день выходят на смену, открывают рабочие очереди и построчно читают реальные пользовательские переписки. Твой черновик стратегии, боли клиентов и закрытые офферы оказываются на экранах сторонних рецензентов, которые ставят оценку тому, насколько гладко бот тебе ответил.
Это не взлом и не утечка базы данных. Это штатная процедура обучения моделей, о которой большинство предпринимателей и маркетологов даже не догадывается. Разложу по слоям, как устроен этот конвейер, почему фильтры личных данных не спасают коммерческую тайну и как настроить работу команды, чтобы не слить клиентские данные чужим людям.
Как устроен Project Lily: калибровка вместо модерации угроз

Когда в новостях пишут, что живые люди просматривают логи нейросетей, первая мысль: «Ну это же служба безопасности ищет экстремистов и вирусы». Такой контур действительно есть. Если автоматика фиксирует прямую угрозу или нарушение закона, диалог уходит на проверку безопасности. Но это отдельная изолированная история. Проект под кодовым названием Project Lily создан для совершенно других задач.
В рамках Project Lily сотни наёмных специалистов занимаются не поиском нарушений, а тонкой настройкой качества ответов. Чтобы языковая модель звучала естественно, не тупила и давала структурированную пользу, разработчики привлекают живых людей. Рецензенты оценивают, насколько удачно алгоритм понял контекст задачи. При этом оператор видит не одну вырванную фразу, а весь диалог целиком: исходный бриф, уточняющие вопросы, промежуточные черновики и финальные правки. Имена учетных записей от проверяющих скрыты, но вся фактура беседы развернута перед ними во всех деталях.
Рабочая смена такого подрядчика устроена как строгий производственный конвейер. Оператор берет задачу из доступного пула и последовательно проходит несколько шагов:
- Фиксация намерения: рецензент читает пользовательский запрос и своими словами формулирует, чего именно хотел добиться автор диалога.
- Разбор вариантов: система выводит на экран до четырех параллельных вариантов генерации на один и тот же промпт.
- Выставление балла: качество ответов оценивается по строгой шкале от 1 до 7, где единица означает откровенно неприемлемый результат, а семерка — ответ, который практически невозможно улучшить.
- Аргументация оценки: рецензент обязан написать текстовое обоснование и выделить как минимум три конкретных удачных или провальных фрагмента текста.
Главный фокус таких проверок — борьба с угодливостью модели и фальшивой человечностью. Инструкторы жестко требуют снижать баллы, если бот пытается притворяться живым человеком: например, пишет «когда я вчера готовил ужин» или «как водитель с опытом я рекомендую». Под штраф попадают избыточные эмодзи, навязчивая лесть, штампованный птичий язык и любые безапелляционные советы по медицине, праву или финансам, если они выданы без опоры на конкретные авторитетные источники.
Иллюзия приватности: дырявый фильтр личных данных и сводка памяти
У любого практика тут же возникнет вопрос: «Разве разработчики не вычищают личные данные перед тем, как отдать текст людям?». Вычищают, но есть нюанс. Перед отправкой в очередь Project Lily все диалоги прогоняются через автоматический Privacy Filter. Его задача — распознать и замазать фамилии, телефонные номера, адреса и названия учетных записей.
Беда в том, что сами разработчики прямо признают: фильтр регулярно ошибается. Алгоритм маскировки хорошо видит типовые структуры вроде номеров телефонов, но легко пропускает чувствительные данные на коротких фразах, редких названиях брендов или специфическом профессиональном сленге. Если в задаче проскочила личная информация, рецензент по регламенту должен отправить ее на эскалацию. Но факт остается фактом: живой человек уже прочитал ваш закрытый текст своими глазами.
Ситуация усугубляется тем, что над пользовательским запросом в интерфейсе проверяющего нередко висит сводка пользовательской памяти (user memories summary). Это блок сведений о том, чем автор обычно занимается, в какой нише работает и в каком регионе примерно находится. Даже если из текста аккуратно вырезали имя директора, связка из локации, специфики ниши, цифр бюджета и уникальных условий сделки позволяет без труда понять, о каком конкретно бизнесе идет речь.
Отдельный наивный миф — попытка защититься заклинаниями внутри самого промпта. Фразы в духе «это строгая коммерческая тайна», «сохрани разговор между нами» или «действует соглашение о неразглашении» для серверной архитектуры ничего не значат. Модель вежливо ответит: «Конечно, я сохраню все в секрете». Но для бэкенда сбора данных эта фраза — просто очередные текстовые токены. Сессия все равно отправляется в общий пул для дообучения и выборочного ручного аудита.
Кто эти рецензенты: монотонная рутина и миф про легкие деньги
Вокруг этой темы мгновенно выросла куча слухов. В русскоязычных медиа даже проскочили заголовки про «золотые горы», где каждому подрядчику якобы платят от пятидесяти долларов в час за простое чтение чужих чатов. Спешу остудить пыл любителей легких денег: это классическое журналистское преувеличение.
Набор специалистов идет через внешние рекрутинговые агентства вроде Crossing Hurdles, а выплаты проводятся через платформы вроде Mercor. Информация про ставку выше пятидесяти долларов в час исходит всего от одного конкретного североамериканского рецензента с профильным высшим образованием и высокой квалификацией, а не является базовым тарифом для всех подрядчиков подряд.
Сами участники описывают эту работу как тяжелую и монотонную рутину. Перед глазами бесконечная лента из сотен однотипных запросов. Инструкции от кураторов постоянно обновляются, а иногда и прямо противоречат друг другу. При этом глубокую проверку фактов по внешним базам данных от рядовых операторов не требуют: на один диалог уходят считаные минуты. Главное — проверить общую логику, тон, отсутствие галлюцинаций и соответствие гайдлайнам.
Важно понимать: подобная практика — стандарт для всей индустрии. Внешних специалистов привлекают практически все ключевые игроки. Компания Anthropic открыто подтверждает проведение ручной оценки диалогов для улучшения Claude при включенных стандартных настройках. Google в справочных материалах прямо указывает, что сохраненные чаты Gemini выборочно просматриваются людьми. Большие языковые модели растут не только на терабайтах веб-страниц, но и на ежедневном ручном труде тысяч наёмных рецензентов.
Четыре опасные точки для маркетинга и редакции
Если ты ведешь контент-завод, развиваешь агентство или настраиваешь лидогенерацию для клиентов, стандартное окно потребительского чата несет четыре прямые точки риска. Вот где бизнес чаще всего спотыкается:
- Глубинные интервью и CustDev: маркетолог закидывает в чат полную аудиорасшифровку интервью с реальным клиентом. В тексте остаются жалобы на текущих подрядчиков, реальные объемы выручки, внутренние конфликты в компании и эмоциональные оговорки. Все это уходит в открытую очередь.
- Неанонсированные офферы и стратегия запуска: команда готовит закрытое коммерческое предложение, прогрев к акции или формулирует новое УТП до официального релиза. Контекст будущего запуска становится доступен третьим лицам задолго до того, как его увидит рынок.
- Сырая финансовая аналитика: выгрузка неанонимизированных таблиц со стоимостью привлечения клиента, конверсиями по каналам и маржинальностью направлений для быстрой сводки или презентации руководству.
- Ловушка кнопок оценки (лайк и дизлайк): нажал палец вверх или вниз под удачным или кривым ответом модели? Во многих системах отправка явной оценки автоматически помечает весь контекст ветки как приоритетный материал и с высокой вероятностью отправляет диалог на ручной разбор рецензентам, даже если в общих настройках профиля стояли ограничения.
Настройки приватности: что реально дает тумблер и где его предел
Главный переключатель в настройках аккаунта — пункт Improve the model for everyone (улучшение модели для всех). На бесплатных тарифах, а также на платных потребительских подписках уровней Plus и Pro этот тумблер по умолчанию включен. Сервис начинает собирать ваши данные с первой же секунды после регистрации, пока вы руками не зайдете в настройки управления данными и не отключите этот кран.
На корпоративных и академических тарифах (Enterprise, Business и Edu) сбор данных для дообучения выключен по умолчанию. Но если вы работаете на стандартных тарифах, важно четко понимать технические границы отключения тумблера:
- Никакой обратной силы: выключение настройки распространяется только на новые диалоги, которые вы создадите после сохранения параметров. Все, что вы отправляли в чат до этого дня, уже могло пройти фильтрацию и осесть в обучающих наборах данных.
- Режим временных чатов: использование временных диалогов защищает текст от попадания в обучающую выборку, но серверы все равно сохраняют копию сессии на срок до тридцати дней на случай проверки безопасности.
- Удаление истории переписки: когда вы нажимаете кнопку удаления диалога, он исчезает из интерфейса, а серверные логи очищаются в течение тридцати дней. Однако если обезличенные фрагменты переписки к этому моменту уже вошли в состав готового обучающего датасета, выковырять их из весов обученной модели физически невозможно.
Регламент информационной гигиены для команды
Понимание того, как устроена изнанка нейросетей, не означает, что нужно в панике закрыть вкладку и вернуться к ручному набору каждого абзаца с нуля. Автоматизация контента и черновиков экономит десятки часов. Но чтобы контент-завод не превратился в дырявое ведро, внутри команды вводятся четыре железных правила гигиены:
1. Обезличивание данных на входе. Любой исходный бриф перед отправкой в окно чата проходит ручную или скриптовую очистку. Реальное название бренда меняем на абстрактную категорию (например, «региональный производитель металлоконструкций»), фамилии и контакты заменяем на условные плейсхолдеры («Клиент 1»), а точные суммы выручки — на проценты и относительные пропорции.
2. Принудительный аудит настроек. В регламент онбординга каждого копирайтера, маркетолога и ассистента вносится обязательный пункт: зайти в настройки аккаунта нейросети и деактивировать участие в программах улучшения моделей.
3. Изоляция закрытых NDA-материалов. Если проект защищен строгим клиентским соглашением о конфиденциальности, работа с текстами ведется либо через специализированные API с гарантированным режимом нулевого сохранения данных, либо через локально развернутые открытые модели на собственном оборудовании.
4. Запрет на эмоциональные реакции в интерфейсе. На черновиках с закрытой клиентской информацией сотрудники не должны нажимать кнопки лайков, дизлайков и встроенных опросов, чтобы лишний раз не провоцировать отправку контекста на ручной аудит подрядчикам.
Чек-лист безопасности перед отправкой промпта
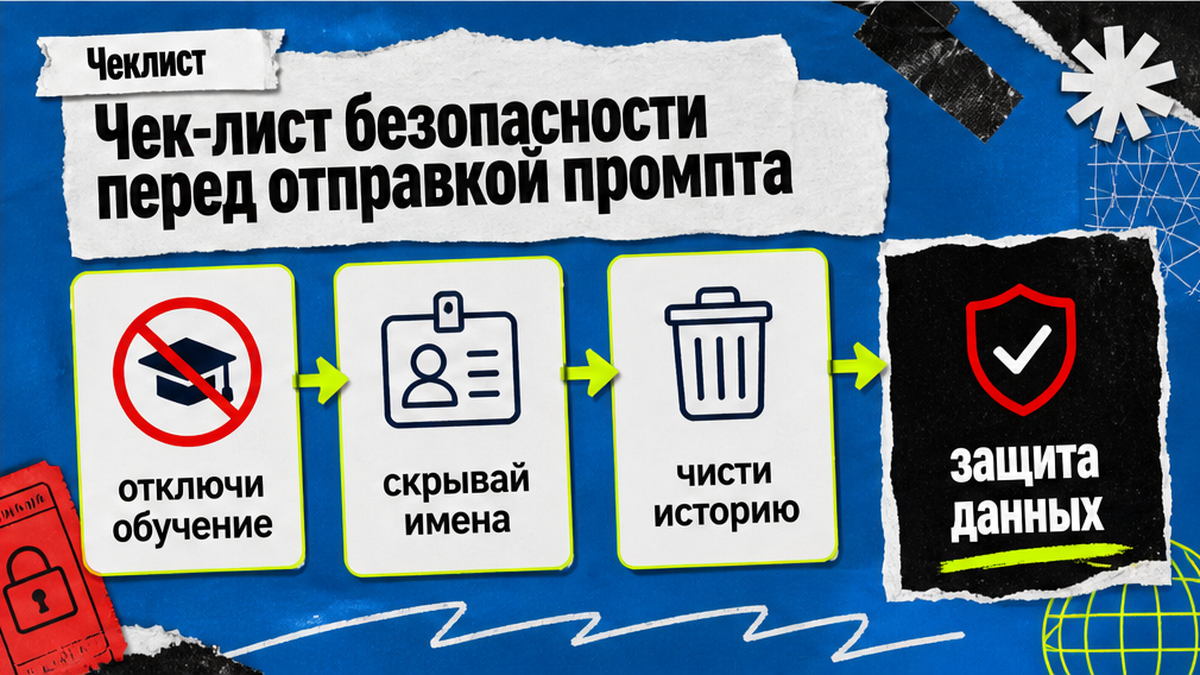
Короткий чек-лист, который стоит держать перед глазами перед отправкой любого рабочего запроса:
- Тумблер проверен: в настройках данных аккаунта отключено обучение модели на ваших диалогах.
- Имена и бренды заменены: в тексте нет реальных фамилий клиентов, телефонных номеров, почтовых адресов и ссылок на закрытые документы.
- Финансы переведены в проценты: абсолютные цифры бюджетов, чистой прибыли и себестоимости заменены на относительные коэффициенты.
- Старые хвосты зачищены: диалоги с конфиденциальными базами и чувствительными черновиками удалены из боковой панели.
- Отказ от иллюзий в тексте: в промпте нет бессмысленных фраз «сохрани в секрете» — защита строится на подготовке данных, а не на доверии к боту.
- Задачи разделены: потребительский чат используется для открытого ресерча и стилистической полировки, а закрытая аналитика обрабатывается в изолированном контуре.
Частые вопросы
Читают ли подрядчики вообще каждый диалог в ChatGPT?
Нет, читать абсолютно все сотни миллионов ежедневных переписок невозможно физически. В Project Lily попадает выборка диалогов, отобранная алгоритмами для калибровки сложных, спорных или показательных ответов. Но при включенной настройке обучения риск попасть в эту выборку есть у любого вашего чата.
Спасает ли платная подписка Plus или Pro от чтения диалогов?
Нет, платная подписка для физических лиц не дает автоматической приватности. На тарифах Plus и Pro функция передачи данных для обучения включена по умолчанию точно так же, как и на бесплатном аккаунте. Автоматическое отключение сбора данных по умолчанию действует только на корпоративных тарифах Enterprise, Business и Edu.
Помогает ли написать в начале промпта «сохрани разговор в строгом секрете»?
Не помогает совсем. Текстовые инструкции в диалоге воспринимаются моделью исключительно как контекст для генерации ответа. Серверная логика платформы эти фразы игнорирует, и сессия обрабатывается по стандартным правилам вашего тарифа и настроек профиля.
Что происходит с информацией после нажатия кнопки удаления чата?
Чат удаляется из бокового меню, а с основных серверов записи стираются в течение тридцати дней. Однако если обезличенные фрагменты вашей переписки до этого момента уже были отобраны и включены в тренировочный датасет, удалить их из готовой нейросети невозможно.
Почему опасно ставить лайки и дизлайки под ответами бота?
Нажатие кнопок обратной связи сообщает платформе, что данный диалог представляет особый интерес для оценки качества. По правилам сервиса такая реакция может направить всю ветку на детальный разбор рецензентам даже в том случае, если общие настройки аккаунта были частично ограничены.
Видят ли рецензенты личный профиль и имя владельца аккаунта?
Прямой логин и имя учетной записи от подрядчиков скрыты, а текст предварительно обрабатывается автоматическим фильтром. Однако операторы видят полный текст беседы и сводку пользовательской памяти, а фильтр личных данных регулярно пропускает редкие названия компаний и контекстные детали.
Смысл простой: окно чата нейросети — это рабочий инструмент, а не личный сейф для секретов. Как только ты перестаешь относиться к диалоговому окну как к закрытой комнате, все встает на свои места. Контент-завод спокойно переваривает черновики и генерирует пользу, а коммерческая тайна клиентов остается под твоим надежным контролем.