
Нейросеть Яндекса ищет подрядчика в отраслевых СМИ
Знакомо: маркетолог с гордостью приносит ссылку на статусную статью в деловом медиа за треть миллиона рублей. Логотип солидный, публикация греет самолюбие основателя, ссылку пересылают партнерам, а в отделе продаж — привычная тишина.
Раньше казалось: мелькни в федеральном издании, и поток клиентов обеспечен на полгода вперед. Но правила игры переписывает генеративный поиск. Сегодня потенциальный заказчик все реже перебирает рекламные баннеры. Он открывает строку поиска и прямо спрашивает: «посоветуй юриста по налоговым проверкам» или «посоветуй компанию по грузоперевозкам». Искусственный интеллект сканирует проиндексированную паутину и прямо над выдачей выдает список проверенных игроков с пояснениями, на кого опираться.
Алгоритмам поисковых нейросетей не важно громкое имя медиахолдинга, если внутри статьи нет прикладной фактуры и решения конкретной задачи. Разберем свежий авторский срез, посмотрим, откуда нейросеть Яндекса черпает рекомендации подрядчиков, и как перестроить контентную работу, чтобы алгоритмы рекомендовали именно тебя.
Запрос клиента и ответ ИИ: почему глянец не кормит CRM
В корпоративном пиаре годами жил стереотип: чем дороже площадка, тем выше отдача. Бизнес копил бюджеты на один громкий выход в федеральной деловой прессе, надеясь закрыть вопрос доверия навсегда. На практике такой подход работал на узнаваемость среди инвесторов, но практически не давал прямых сервисных заявок.
Когда человек приходит в поиск с реальной коммерческой проблемой, его психология устроена иначе. Ему не интересны макроэкономические прогнозы и отчеты о слияниях. Ему нужно решить задачу: защитить бизнес от доначислений налоговой, перевезти груз без срыва сроков или построить дом из надежных материалов.
Генеративный блок Яндекса на базе Алисы AI создан для экономии времени пользователя. Если алгоритмы видят, что человеку требуется емкий совет, они формируют текстовое резюме прямо над органическими ссылками. Поисковая нейросеть не цитирует страницы дословно (кроме точных цитат), а собирает смысловую выжимку из массива проиндексированных документов. Под текстом рекомендаций выстраивается блок первоисточников, на которые модель опиралась при ответе.
Принципы отбора страниц поисковым ИИ отличаются от классического ранжирования:
- Логический порядок вместо позиций: ссылки под нейроответом располагаются не по весу страниц, а привязываются к смысловым тезисам текста. Ссылка встает ровно под той фразой, которую подтверждает.
- Плотность практической пользы: модель ищет страницы с высокой концентрацией проверенных фактов, регламентов, пошаговых алгоритмов и свежего опыта.
- Расширенный список источников: под одним ответом сносок может оказаться больше, чем ссылок на первом экране выдачи, причем профильный сайт может упоминаться несколько раз.
- Постоянное обновление: поисковые индексы и модели пересчитываются регулярно, поэтому формулировки ответа и состав источников меняются в разные дни и часы.
Справка поисковика предупреждает: генеративные ответы могут содержать неточности, поэтому пользователю рекомендуется переходить по ссылкам и проверять факты. Именно эти ссылки становятся главным мостом между советом нейросети и сайтом эксперта.
Анатомия одного замера: кого нейросеть Яндекса зовет в источники
Обратимся к авторскому срезу Александра Краснобаева. Замер был выполнен 28 октября 2026 года и опубликован на vc.ru 29 октября 2026 года. Автор протестировал реакцию нейросети Яндекса на 12 конкретных клиентских запросов в сервисных сферах по модели прямого подбора исполнителя: «посоветуй юриста», «посоветуй компанию по перевозкам», «посоветуй застройщика» и аналогичных.
Сразу зафиксируем границу: это не официальный отчет Яндекса, а срез на один конкретный день. Алгоритмы подвижны, но сама структура распределения источников в этом эксперименте вскрывает логику искусственного интеллекта.
Картина по 12 запросам получилась показательной:
- Выборочный запуск ИИ-блока: из 12 вопросов блок с рекомендациями и источниками появился в 8 случаях. В 4 запросах блок со ссылками не сформировался вовсе — в таких ситуациях поиск оставляет обычную выдачу или переносит ответ во вкладку «Алиса» под поисковой строкой.
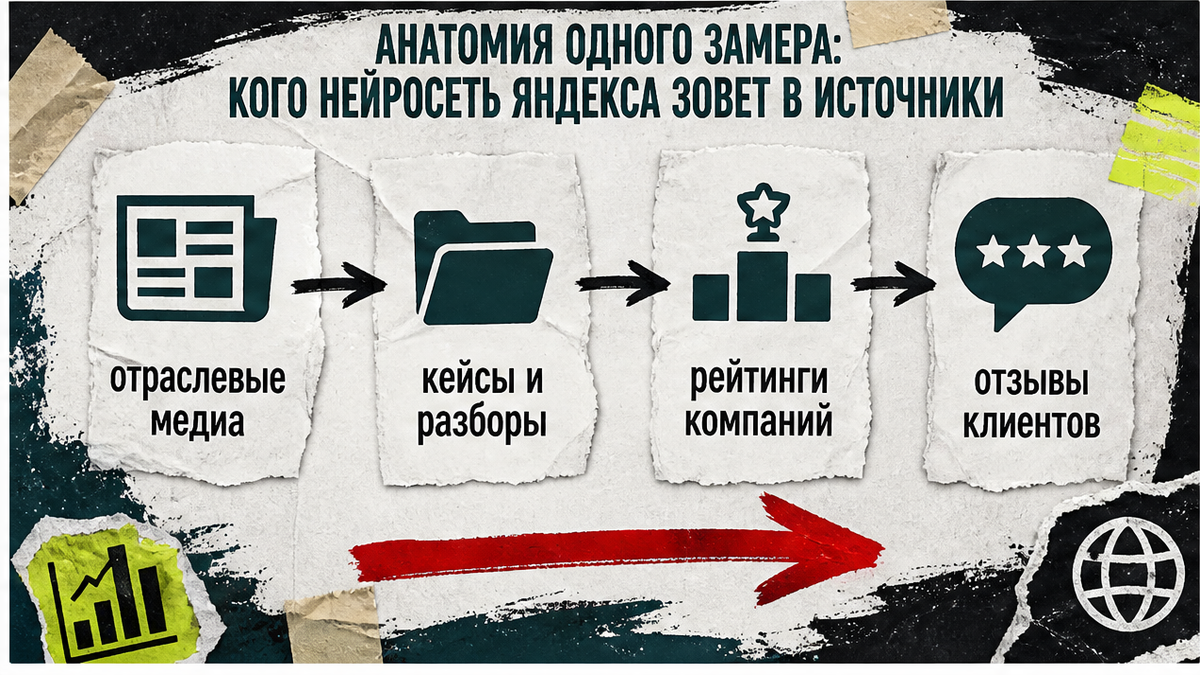
- Федеральный глянец вне игры: издания первого эшелона (Forbes, РБК, «Ведомости») не появились в источниках сгенерированных ответов ни разу (0 упоминаний из 8). Федеральное издание «Коммерсантъ» появилось один раз (1 упоминание).
- Отраслевые издания: профильные медиа конкретных индустрий вошли в источники 4 ответов из 8.
- Открытые платформы блогов: статьи и кейсы на vc.ru, где компании открыто разбирают свой практический опыт, вошли в источники 4 ответов из 8.
- Агрегаторы, рейтинги и отзывы: специализированные базы данных, отраслевые реестры и сайты с оценками клиентов присутствовали в 6 ответах из 8.
Сумма категорий (0 + 1 + 4 + 4 + 6) превышает восемь, поскольку классы источников пересекаются: при подготовке одной рекомендации нейросеть одновременно берет фактуру из профильной аналитической статьи, подтягивает кейс с открытой площадки и сверяется с тематическим рейтингом.
Смысл простой: когда пользователь ищет подрядчика для дела, алгоритм игнорирует общие медиа и идет туда, где есть предметная глубина, технические детали и отзывы живых заказчиков.
Шесть ниш на пальцах: как алгоритм перебирает экспертов
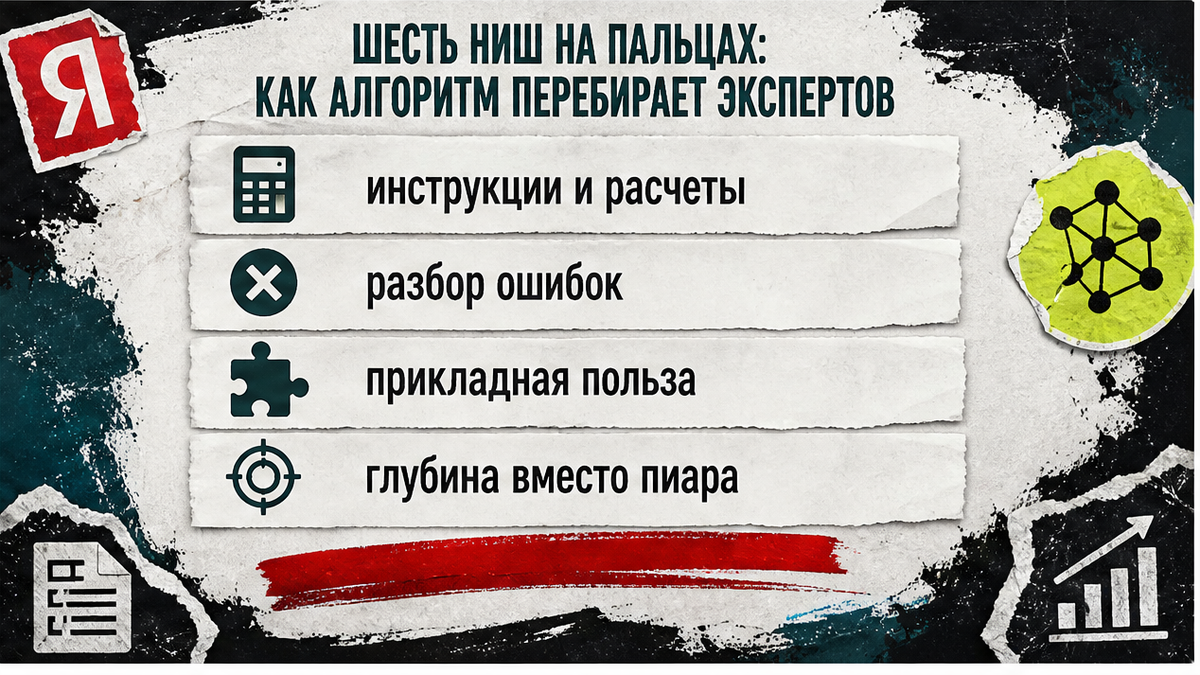
Детализация по конкретным направлениям внутри авторского среза раскрывает, как поисковая модель выбирает первоисточники. В шести нишах, зафиксированных автором, прослеживается четкая опора на профильный контент:
- Налоги и юридический консалтинг: на запрос о поиске юриста по налоговым проверкам нейросеть выдала 16 источников. Из них 3 ссылки вели на материалы портала «Клерк», причем первая ссылка стояла прямо под начальной фразой совета. Ни одной ссылки на общественно-политические медиахолдинги в блоке не оказалось.
- Грузоперевозки и коммерческая логистика: при подборе транспортного подрядчика алгоритм сослался на статьи того же «Клерка» и данные профессионального рейтинга перевозчиков ATI.
- Загородное строительство: рекомендации формировались на базе специализированных порталов о малоэтажном домостроении, где сравниваются технологии возведения стен, фундаменты и сметы.
- Иммиграционные услуги: нейросеть выдала предупреждение о рисках стопроцентной предоплаты и давления на клиента, сославшись на «Коммерсантъ» и портал зарубежной недвижимости Prian, где основатель профильной компании разбирал схемы обмана на рынке.
- Медицинские центры и клиники: подбор специалистов и клиник строился вокруг специализированных сервисов отзывов о врачах и профильных медицинских агрегаторов.
- Агентства недвижимости: источниками для рекомендаций стали сервисы Домклик и Циан, геоинформационные карты, а также экспертные разборы реальных сделок на vc.ru.
Если твой бизнес занимается налогами, алгоритм ищет подробную инструкцию по проверке или разбор свежей судебной практики. Если ты строишь дома — нейросети нужен разбор ошибок при заливке фундамента или расчет сметы. Практика и глубина бьют абстрактный пиар.
Экономика публикаций: статус на всю страну против прикладной пользы
В рамках эксперимента автор спросил нейросеть Яндекса напрямую: в каком медиа эффективнее опубликовать статью о компании — в крупном деловом или в отраслевом? Ответ модели оказался прагматичным: выбор зависит от бизнес-задачи. Если компании нужен масштабный федеральный охват, узнаваемость бренда и статус для переговоров с инвесторами — стоит идти в крупные деловые издания. Если же цель — привлечь клиентов в конкретной нише, решающим фактором становится присутствие в отраслевых СМИ и профессиональных сообществах.
Давай переведем этот выбор на язык денег. В срезе приведен прайс на размещение заказных материалов, актуальный на конец сентября 2026 года (с учетом налогов):
| Площадка или тип издания | Примерная стоимость выхода (руб.) | Фокус внимания аудитории |
|---|---|---|
| Forbes, «Ведомости», «Коммерсантъ» | ~312 000 | Инвесторы, топ-менеджмент, общий статус |
| РБК | ~260 000 | Широкая деловая аудитория, рынки |
| Ведущие отраслевые СМИ («Клерк») | ~124 800 | Профильные специалисты, бухгалтеры, юристы |
| Медиана по изданиям второго эшелона | ~93 600 | Узкие нишевые заказчики, практики |
Бюджет одной имиджевой публикации в федеральном издании первого эшелона сопоставим с серией из двух-трех глубоких практических материалов в ведущей отраслевой прессе. А на нишевых площадках второго эшелона за те же деньги можно выпустить три-четыре подробных разбора с кейсами.
При этом вероятность того, что поисковая нейросеть возьмет фактуру из прикладной отраслевой статьи при ответе на сервисный вопрос клиента, в разы выше. Одна статья в глянце греет самолюбие, а регулярная сетка профильных материалов кормит поисковые алгоритмы ответами на реальные запросы заказчиков.
Куда на самом деле уходит клик из нейроответа
В генеративном поиске путь клиента устроен иначе, чем в контекстной рекламе. Здесь работают три параллельных сценария взаимодействия:
Сценарий 1: Прямое запоминание бренда. Человек получает рекомендацию и название подходящей компании прямо в тексте сгенерированного блока. Если аргументация выглядит убедительно, доверие формируется на экране поиска. Пользователь копирует название бренда и идет искать сайт напрямую через поиск или карты.
Сценарий 2: Переход на внешнюю экспертную статью. Ссылки-источники под нейроответом ведут на страницу, откуда алгоритм взял информацию. В примере с налогами ссылка вела на аналитику портала «Клерк», в иммиграции — на разбор рисков в прессе. Потенциальный клиент переходит на авторитетное медиа, читает статью с примерами из практики и внутри текста знакомится с автором кейса.
Сценарий 3: Сверка по рейтингам и картам. Если ответ сформирован на основе агрегаторов или отзывов, человек кликает по сноске и попадает в каталог, где видит рейтинг компании, объем выполненных заказов и отзывы клиентов.
В сервисе Яндекс Вебмастер есть инструмент «Видимость сайта в Алисе AI». Он показывает долю упоминаний ресурса (Share of Voice) и динамику за последние три месяца с обновлением раз в неделю. Однако инструмент учитывает только те запросы, по которым сайт уже занимает высокие позиции в органике, и не показывает количество реальных кликов или показов. Это метрика информационной представленности, а не счетчик переходов в CRM.
Грабли и красные флаги: на чем спотыкаются компании
Пытаясь подстроиться под поисковые алгоритмы, бизнес регулярно совершает типичные ошибки:
- Иллюзия вечной гарантии по одному замеру: если компания попала в ответ нейросети сегодня, это не значит, что она останется там навсегда. Модели регулярно дообучаются, а поисковые индексы обновляются. Если конкуренты публикуют свежую фактуру активнее, алгоритм быстро переключится на их материалы.
- Попытка скормить нейросети пустую рекламу: прямые рекламные тексты алгоритмы отсеивают сразу. ИИ ищет цифры, регламенты, судебную практику, технические параметры и разборы ошибок. Без твердой фактуры текста для модели не существует.
- Замыкание контента в закрытых каналах: многие компании пишут полезные разборы, но выкладывают их исключительно в закрытые чаты или внутренние базы знаний. Поисковый робот не имеет туда доступа. Если текста нет в открытом веб-индексе, нейросеть не сможет прочитать его и сослаться на опыт.
- Игнорирование открытых площадок и карточек: пренебрежение открытыми контентными платформами вроде vc.ru, картами и отраслевыми каталогами лишает бизнес видимости. Поисковый ИИ регулярно берет оттуда социальные подтверждения и живые кейсы.
- Попытки манипуляций с техническими файлами: директивы Disallow для роботов YandexAdditional и YandexAdditionalBot в файле robots.txt позволяют только запретить использовать страницы сайта в ответах Алисы AI (изменения учитываются в течение 2–14 дней). Команды для принудительного включения сайта в ответы не существует. Попадание обеспечивается только качеством и авторитетностью контента.
Практический конвейер: как готовить материалы под поисковый ИИ
Чтобы регулярно появляться в источниках и рекомендациях поискового искусственного интеллекта, контентную работу нужно выстраивать как системный конвейер:
- Собери карту реальных клиентских вопросов: выпиши 20–30 формулировок, по которым люди ищут специалистов в твоей нише («как выбрать подрядчика по…», «посоветуй юриста по…», «типичные ошибки при монтаже…»). Прогони эти запросы через поиск и посмотри, какие площадки сегодня стоят в источниках ответов.
- Запусти регулярные публикации в профильных СМИ: определи 2–3 главных отраслевых портала в своей теме. Готовь для них экспертные материалы с разбором законов, сложных регламентов и нетипичных ситуаций. Органично упоминай название компании, имена ведущих экспертов и конкретные детали реализованных проектов.
- Веди открытый блог с честными кейсами: заведи корпоративный блог на открытой площадке уровня vc.ru. Пиши о реальных рабочих процессах: сколько стоил проект, где возникли сложности, как их преодолели и каких результатов добились. Для алгоритмов это первоклассный источник прикладного опыта.
- Наведи порядок в каталогах, картах и отзывах: проверь карточки компании во всех ключевых отраслевых рейтингах, на геосервисах и сайтах отзывов. Заполни актуальные прайс-листы, перечень услуг, следи за свежими оценками и обязательно отвечай на отзывы клиентов.
- Укрепи собственный сайт твердой фактурой: посадочные страницы не должны быть пустыми визитками. Добавь подробные калькуляторы, образцы типовых договоров, технологические карты и развернутые ответы на сложные технические вопросы. Высокая позиция сайта в органической выдаче — базовый фундамент для внимания поискового ИИ.
Частые вопросы
Гарантирует ли статья в авторитетном отраслевом СМИ попадание в ответ нейросети?
Нет, стопроцентной гарантии не дает ни одна публикация в мире. Поисковые алгоритмы Яндекса отбирают первоисточники динамически, оценивая оригинальность, экспертность, содержательность и соответствие вопросу пользователя. Качественный материал в профильном медиа повышает шансы на цитирование, но итоговый состав ссылок регулярно пересчитывается моделями.
Почему в ответах на запросы о поиске подрядчиков почти нет Forbes и РБК?
Федеральная деловая пресса пишет о макроэкономике, инвестициях, слияниях и корпоративных новостях. Когда пользователь ищет конкретного исполнителя (юриста, строителя, перевозчика), алгоритмам требуется прикладной опыт, разборы типовых граблей, регламенты и отзывы, за которыми поиск обращается к отраслевой прессе и каталогам.
Можно ли отслеживать прямые клики и заявки из блока нейроответа в Вебмастере?
Инструмент «Видимость сайта в Алисе AI» в Яндекс Вебмастере фиксирует только долю упоминаний бренда (Share of Voice) и ее динамику за три месяца по тем запросам, где сайт уже имеет сильные позиции в органике. Количественную статистику прямых переходов и показов этот инструмент не отображает.
Как закрыть сайт от использования материалов в ответах Алисы AI?
Для запрета показа данных с сайта в генеративных ответах нужно настроить директиву Disallow в файле robots.txt для роботов YandexAdditional или YandexAdditionalBot. Поисковик учитывает изменения по мере обновления базы данных в срок от 2 до 14 дней.
Попадают ли посты из закрытых каналов мессенджеров в ответы поискового ИИ?
Поисковые роботы индексируют исключительно открытые веб-страницы. Если экспертный контент опубликован в закрытом сообществе, закрытом чате или базе знаний под паролем, робот не может его прочитать, и для поисковой нейросети этот материал не существует.
Как часто меняется список источников в блоке рекомендаций Алисы AI?
Список первоисточников и формулировки ответов могут обновляться каждый день и даже в течение нескольких часов. Это обусловлено непрерывным дообучением языковых моделей, обновлением поисковых индексов и персонализацией выдачи под контекст пользователя.
Короткий вывод
Генеративный поиск не отменяет пиар, но жестко расставляет приоритеты. Дорогая статусная публикация в общем глянце может порадовать руководство, но когда клиент ищет конкретного исполнителя, алгоритмы нейросетей обращаются к профильным медиа, открытым кейсам и отраслевым рейтингам.
Для устойчивого присутствия в рекомендациях искусственного интеллекта не нужны секретные хаки. Нужна понятная регулярная работа: писать прикладные статьи в профильные издания, делиться реальным опытом на открытых платформах и держать в идеальном порядке карточки на картах и в каталогах. Тот, кто системно кормит поиск твердой пользой, становится главным ответом на прямой вопрос клиента.