
Нейросеть называет бренд в ответе без перехода на сайт
Утро. В таблице контент-завода все слоты горят зелёным: посты улетели в Telegram, VK, Дзен и MAX, отложка забита на две недели вперёд, счётчики просмотров исправно крутятся. Маркетолог ставит галочку в отчёте и закрывает ноутбук с чувством выполненного долга. Кажется, конвейер работает как часы и привлекает внимание к продукту.
А в это же самое время потенциальный покупатель открывает чат с нейросетью. Он не листает страницы поисковой выдачи, не кликает по рекламным баннерам и не изучает длинные ленты постов. Он пишет в диалоговое окно простой житейский запрос: «Посоветуй надёжный сервис или подрядчика под такую-то задачу». Модель за пару секунд собирает готовый ответ, сравнивает три варианта и прямо называет конкретные бренды. Человек делает выбор прямо внутри диалога — без перехода на сайт компании и без единого клика.
В этот момент между бодрыми графиками контент-завода и реальной кассой возникает глухой разрыв. Конвейер может штамповать десятки постов в неделю, но в итоговой рекомендации ИИ звучат имена твоих прямых конкурентов. Разберёмся без пафоса и заумных терминов, как нейросети выбирают бренды для рекомендаций и почему старые привычки маркетологов здесь дают сбой.
Отчёт кормит графики, а выбор происходит в чате

Классический путь клиента в поиске всегда держался на переходе по ссылке. Пользователь вбивал запрос, получал простыню из десяти синих ссылок, кликал по первым трём сайтам и уже там читал условия, сравнивал цены и оставлял заявку. Вся маркетинговая машина годами затачивалась под одну цель: заманить человека на страницу любой ценой.
В генеративном поиске и диалоговых чатботах логика перевернулась с ног на голову. Нейросеть сама читает десятки источников, фильтрует шелуху и отдаёт человеку сухой синтезированный вывод. Если раньше покупатель тратил полчаса на самостоятельное чтение сайтов, то теперь он перекладывает эту работу на модель.
В начале сентября 2026 года на этот фундаментальный сдвиг обратили внимание профильные аналитики и диджитал-агентства (в частности, агентство Айnet, представившее сервис Айnet Радар для оценки GEO-видимости). Их специалисты зафиксировали ключевой факт: человек всё чаще принимает решение о покупке или выборе поставщика на основе текста ответа нейросети, даже не открывая сайт компании.
Присутствие бренда в ответах ChatGPT, Gemini, Perplexity или в быстрых ответах Алисы становится самостоятельной метрикой. Она существует параллельно с привычным поисковым трафиком и позициями в выдаче. Даже когда интерфейс поисковой нейросети прикрепляет кликабельные сноски на первоисточники, большинство пользователей по ним просто не кликает: готового текста в чате им вполне достаточно. Если компании нет в этом финальном абзаце, для клиента её не существует в момент принятия решения.
Почему в выдаче нейросетей не существует «первого места»

В привычном SEO маркетологи годами боролись за железобетонную строчку в топе по конкретному ключевому запросу. Занял первое место по фразе — собираешь сливки трафика месяцами, пока конкуренты не перебьют ставку или не закупят больше ссылок. В мире генеративных моделей концепция стабильного первого места умерла.
Ответ нейросети формируется динамически в режиме реального времени. Он зависит от десятков плавающих параметров: точной формулировки запроса, выбранной языковой модели, контекста предыдущего диалога и текущего информационного фона. В одной системе бренд может выйти на первое место в списке рекомендаций, а в другой модели при похожем вопросе не появиться вовсе.
Именно поэтому один случайный запрос маркетолога в чат («посоветуй лучшую компанию в нашей нише») — это чистой воды самообман. Отраслевые замеры показывают, что разброс видимости на единичных прогонах из-за статистического шума может достигать 30%. Реальное положение дел начинает проясняться только при анализе десятков разнообразных обращений. Оценивать видимость бренда приходится сразу по целому вееру естественных сценариев: от общего поиска услуги и сравнения альтернатив до подбора поставщика под жёсткие нестандартные требования.
Что читает нейросеть: открытый веб против закрытых постов
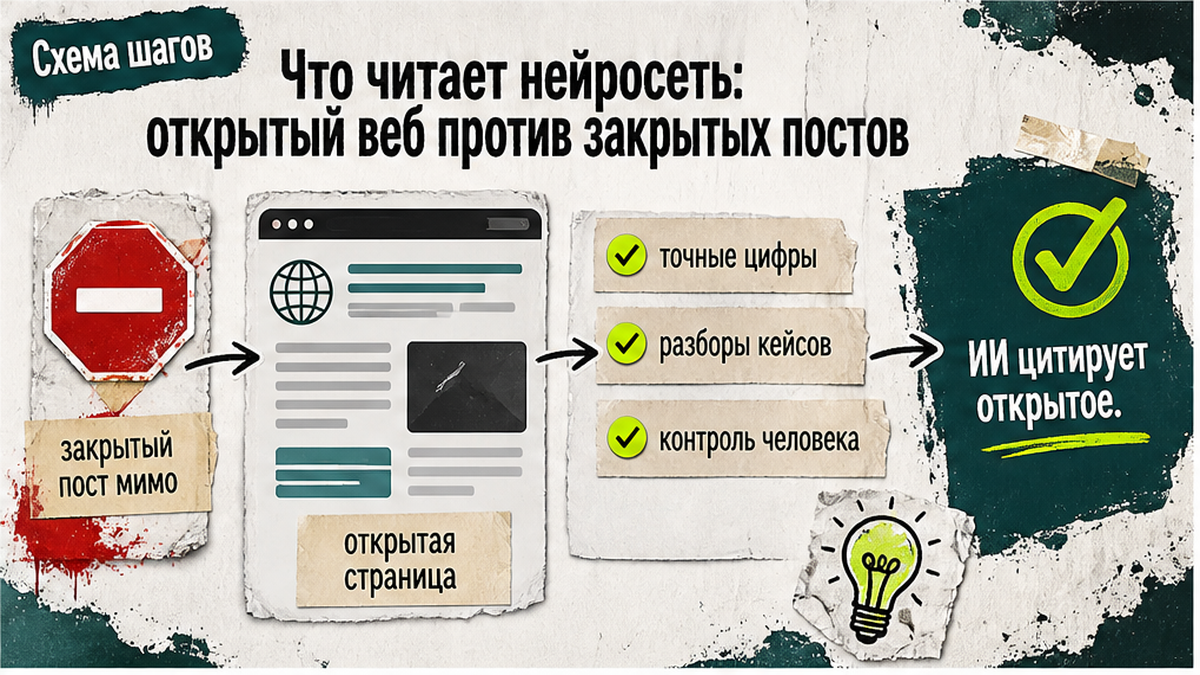
Самое опасное заблуждение контент-завода — уверенность в том, что массовая генерация однотипных постов в свои каналы решит проблему. Маркетолог запускает автопостинг, выгружает сотни сгенерированных текстов и ждёт, что нейросеть немедленно начнёт цитировать бренд. Так это не работает. Механика работы генеративных систем опирается на строгие правила поисковой индексации:
- Опора на классический поисковый индекс: Официальные технические руководства Google Search Central прямо говорят: оптимизация под генеративные функции поиска остаётся частью классического SEO. ИИ-ответы собираются на базе обычного поискового индекса через механизмы поиска по базе знаний (RAG) и веерных подзапросов. Чтобы страница стала источником данных для нейросети, она обязана быть проиндексирована и допущена к показу в стандартной поисковой выдаче. Никаких секретных файлов вроде llms.txt или экзотической микроразметки поисковики не требуют и не учитывают.
- Борьба с автоматическим спамом: Массовая штамповка сотен низкопробных страниц ради накрутки упоминаний официально классифицируется поисковыми системами как злоупотребление масштабным контентом (scaled content abuse). Поисковые роботы отфильтровывают такой мусор. Нейросетям нужны содержательные, оригинальные материалы с реальным практическим опытом, решающие конкретную задачу живого человека.
- Прямая связь с позициями в поиске Яндекса: Быстрые ответы Алисы AI также строятся на базе источников с высоким поисковым авторитетом. Официальный показатель присутствия сайта в ответах Алисы (доля голоса, или Share of Voice в Яндекс.Вебмастере) рассчитывается только по тем запросам, по которым сайт уже занимает высокие позиции в органической выдаче. Если страницы нет в топе обычного поиска, в быстрый ответ она не попадёт.
- Ограничения закрытых каналов: Публикации внутри закрытых лент мессенджеров Telegram или MAX не индексируются поисковыми роботами так же свободно, как открытые страницы в интернете. Чтобы нейросеть цитировала материалы завода, контент должен выходить на открытых индексируемых площадках — в статьях Дзена, на собственном сайте компании и в публикациях отраслевых изданий. Причём независимые медиа и разборы со стороны нейросети цитируют даже охотнее, чем корпоративные лендинги.
Инструменты съёма — это термометр, а не волшебная таблетка
С ростом интереса к генеративному поиску на рынке появились специализированные сервисы мониторинга видимости в нейросетях. Они помогают провести первичный аудит: наглядно показывают, в каких пользовательских сценариях компания систематически уступает конкурентам, и фиксируют, как изменения в контентной стратегии отражаются на рекомендациях моделей.
Однако важно отдавать себе отчёт: любой сервис аналитики — это всего лишь термометр. Он измеряет текущую температуру в палате, но сам по себе болезнь не лечит и упоминания бренда в ответах ИИ не производит. Покупка подписки на мониторинг не гарантирует, что модель завтра начнёт рекомендовать твою компанию.
Если у бизнеса пока небольшой объём поискового трафика и скромный средний чек, тратить бюджет на дорогие системы непрерывного мониторинга преждевременно. Главный фокус контент-завода должен быть направлен на саму фактуру: создание глубоких, полезных статей на открытых площадках, разбор реальных клиентских ситуаций и формирование устойчивого следа в экспертных источниках.
Пошаговый конвейер: как готовить контент для ответов ИИ
Чтобы материалы контент-завода работали на видимость в нейросетях, конвейер нужно перестроить с механической штамповки постов на системную работу с открытыми источниками:
- Создавай открытый индексируемый фундамент: Перестань запирать всю пользу исключительно в лентах закрытых каналов. Каждая сильная мысль, разбор кейса или техническая инструкция должны выходить в виде полноценной статьи на сайте или в Дзене, где поисковые роботы могут свободно прочитать и проиндексировать текст.
- Давай проверяемую фактуру вместо общих слов: Модели игнорируют водянистые рассуждения «ни о чём». Включай в статьи точные цифры, конкретные сценарии, таблицы сравнения, плюсы и минусы решений. Чем выше плотность реального опыта в тексте, тем выше вероятность, что модель использует его как надёжный источник.
- Формируй независимый след: Публикуй экспертные материалы на отраслевых площадках и в профильных медиа. Нейросети охотно опираются на сторонние независимые разборы, когда сравнивают альтернативы в одной нише.
- Тестируй видимость по живым сценариям: Не пытайся оценить присутствие бренда одним хвалебным запросом. Составь список из 20–30 реальных клиентских вопросов: «кого выбрать для монтажа», «какой сервис дешевле для малого бизнеса», «сравнение решений под ключ». Прогоняй эти сценарии регулярно и смотри, в каких темах бренд выпадает из поля зрения модели.
- Держи человека в контуре контроля: Сырой вывод генеративных моделей полон речевых штампов и общих фраз. Редактор обязан проверять черновики, убирать синтетический мусор и насыщать текст живой практикой.
Грабли и красные флаги: на чём теряют деньги и время
При попытке заскочить в генеративную выдачу предприниматели и маркетологи регулярно наступают на одни и те же грабли:
- Штамповка сотен мусорных страниц: Попытка сгенерировать 500 однотипных статей ради ключевых слов приводит только к санкциям за поисковый спам. Поисковики пессимизируют такие сайты, закрывая дорогу и в обычный поиск, и в ответы ИИ.
- Иллюзия одного удачного запроса: Увидев название своей компании в одном ответе чатбота, маркетолог успокаивается и докладывает руководству о победе. На следующий день формулировка запроса чуть меняется — и бренд исчезает из рекомендаций.
- Надежда на закрытые мессенджеры: Рассчитывать, что посты из закрытого Telegram-канала сами по себе обучат поисковую модель Яндекса или Google — пустая трата времени. Без открытого веба поисковые роботы этот контент не видят.
- Гонка за метриками вместо решения проблем: Покупка дорогих инструментов съёма до того, как на сайте появились содержательные статьи, не приносит ничего, кроме красивых графиков в отчёте.
Короткий чек-лист перед запуском статьи в открытый веб
Прежде чем отправить материал контент-завода в публикацию, проверь его по пяти пунктам:
- Материал опубликован на открытой индексируемой веб-странице (в Дзене или на сайте), а не только в закрытом канале.
- В тексте есть решение конкретной прикладной задачи читателя, а не просто пересказ чужих определений.
- В статье присутствуют проверяемые факты, цифры, сравнения или пошаговые сценарии.
- Текст вычитан человеком: убраны пустые вводные конструкции и следы автоматической генерации.
- Заголовок статьи точно отражает суть проблемы без кликбейта и пустых обещаний.
Частые вопросы
Можно ли проверить видимость бренда одним запросом в чат?
Нет, один единичный запрос не даёт объективной картины. Из-за динамической природы генеративных моделей и изменчивости контекста ответ может меняться от сессии к сессии. Разброс результатов на малых выборках достигает 30%. Достоверную оценку даёт только регулярный замер по десяткам разнообразных пользовательских сценариев.
Попадают ли посты из закрытых каналов мессенджеров в ответы ИИ?
Поисковые генеративные системы строят свои ответы на базе открытого, доступного для индексации веба. Закрытые публикации внутри мессенджеров не попадают напрямую в поисковые базы. Базой для цитирования служат открытые статьи в Дзене, страницы сайтов и материалы отраслевых медиа.
Нужны ли специальные файлы llms.txt или секретная разметка для нейросетей?
Поисковые системы, включая Google, официально не требуют специальных файлов вроде llms.txt и не используют их для формирования генеративных ответов. Модели опираются на стандартный поисковый индекс, качественную структуру страниц и авторитет контента в традиционной поисковой выдаче.
Что делать, если нейросеть советует конкурента, а не нас?
Необходимо проанализировать, на какие источники опирается модель при ответе. Чаще всего конкуренты представлены на авторитетных отраслевых ресурсах, имеют сильные статьи в открытом поиске и реальные отзывы. Задача контент-завода — выпустить подробные сравнительные материалы и закрыть информационные пробелы на открытых площадках.
Сухой остаток
Контент-завод может исправно выполнять норматив по публикациям и радовать красивыми графиками охватов. Но если покупатель принимает решение внутри диалога с нейросетью, побеждает тот, чьи открытые материалы стали фундаментом для ответа модели.
Здесь нет волшебных таблеток и секретных кнопок. Нейросети не читают закрытые ленты и не верят однотипному спаму. Они ищут содержательный, авторитетный и полезный контент в открытом вебе. Задача бизнеса — методично наполнять этот веб качественной практикой, держать человека в контуре проверки и опираться на твёрдые факты.